Nella ricerca umanistica — in archeologia, storia, geografia storica, studi sul paesaggio — la dimensione spaziale è quasi sempre parte dell’argomentazione. Sapere quali luoghi discute un contributo, e con quale frequenza, è un’informazione preziosa tanto quanto conoscerne il tema o la cronologia. Estrarla a mano da centinaia di PDF, però, non è praticabile.
geoNamesFromPdf nasce per automatizzare questo passaggio. È uno strumento a riga di comando (con una interfaccia grafica opzionale) sviluppato presso il LAD – Laboratorio di Archeologia Digitale della Sapienza Università di Roma, che individua i toponimi presenti in un documento PDF e ne restituisce un elenco ordinato, eventualmente arricchito di coordinate. Il progetto è open source (licenza MIT) ed è disponibile su GitHub.
Lo strumento è stato presentato per la prima volta nell’ottobre 2025. Questo articolo ne descrive la versione rivista nell’agosto 2026, che introduce cambiamenti sostanziali sia nell’architettura sia nelle funzionalità.
Che cosa è cambiato nella revisione del 2026
La prima versione risolveva bene il caso d’uso essenziale — dammi un PDF, ti restituisco i nomi di luogo — ma mostrava alcuni limiti quando la si portava sul lavoro reale con volumi bibliografici ampi e con documentazione archeologica. La revisione interviene su cinque fronti.
Correzioni. La funzione che confrontava il testo con un gazetteer esterno conteneva un errore nell’espressione regolare (una sequenza di escape raddoppiata) che, di fatto, impediva qualunque corrispondenza: da riga di comando l’opzione --gazetteer non trovava mai nulla. Il messaggio di errore per un file inesistente era fuorviante, il rilevamento della lingua non era riproducibile fra esecuzioni successive, e i documenti molto lunghi superavano il limite interno di spaCy interrompendo l’analisi. Tutti questi problemi sono stati risolti.
Architettura. Tutta la logica di estrazione è stata spostata in un modulo unico e privo di effetti collaterali (core.py), condiviso dalla riga di comando e dall’interfaccia grafica, che in precedenza duplicavano — e avevano cominciato a divergere — lo stesso codice. Il testo viene ora elaborato pagina per pagina, la pipeline linguistica carica solo i componenti necessari al riconoscimento delle entità e i modelli restano in cache: l’analisi è più rapida e la memoria richiesta è minore. L’interfaccia grafica esegue l’elaborazione in un thread separato e non si blocca più durante le attese.
Output strutturato. Oltre all’elenco testuale, lo strumento produce ora CSV, JSON e GeoJSON. Ogni toponimo porta con sé il numero di occorrenze, le pagine in cui compare e la sua provenienza (riconoscimento automatico, gazetteer, o entrambi). Il risultato non è più una lista di stringhe ma un piccolo dataset pronto per un GIS o un database.
Gazetteer come dato geografico. Il gazetteer può ora essere un file .csv o .tsv con colonne per identificativo e coordinate: quando ci sono, le coordinate vengono associate ai toponimi e riversate nel GeoJSON. È inoltre disponibile una modalità solo gazetteer, che disattiva il riconoscimento automatico ed è pensata per il latino, il greco antico e le altre lingue per cui non esistono modelli linguistici affidabili.
Integrazione con Zotero. Un secondo strumento grafico, zotero_assistant.py, applica l’estrazione direttamente a una libreria Zotero: scorre i record uno per uno, propone i tag geografici e — dopo l’approvazione dell’utente — li scrive nell’item. È descritto più avanti.
Una scelta di fondo è rimasta invariata ed è stata anzi consolidata: lo strumento funziona interamente offline e non dipende da servizi di intelligenza artificiale esterni. Tutti i modelli girano in locale sulla macchina dell’utente.
Come funziona
Il flusso di elaborazione si articola in sei fasi:
- Estrazione del testo dal PDF con PyMuPDF, pagina per pagina, eventualmente limitata a un intervallo (
--pages "10-50"). - Rilevamento della lingua con langdetect, a seme fisso per garantire risultati riproducibili; è possibile forzare la lingua con
-l. - Caricamento del modello: viene caricata — e messa in cache — una pipeline spaCy ridotta al solo riconoscimento delle entità.
- Riconoscimento delle entità geografiche (
GPE,LOC,FAC), raccolte per pagina con il conteggio delle occorrenze. - Confronto con il gazetteer, se fornito: una singola passata sul testo, sensibile ai confini di parola, insensibile a maiuscole e diacritici, capace di riconoscere nomi composti.
- Post-elaborazione: rimozione dei nomi in lista di esclusione, deduplicazione, ordinamento e serializzazione nel formato richiesto.
Un’esecuzione tipica su un testo italiano:
python geoNamesFromPdf.py articolo.pdf -l it🌐 Detected language: it🧠 Using engine 'spacy' / model: core_news_lg v3.8.0
📍 Toponyms found in the PDF (12 total):
- Atene- Bologna- Egitto- Firenze- Grecia- Italia- Mediterraneo- Milano- Napoli- Roma- Sicilia- TevereCon --details lo stesso elenco riporta, per ciascun toponimo, l’etichetta, il numero di occorrenze e le pagine; con -f csv o -f json le stesse informazioni vengono esportate in forma tabellare o strutturata.
Motori di riconoscimento
Il motore predefinito è quello dei modelli CNN «large» di spaCy, un buon compromesso fra accuratezza, velocità su CPU e dimensioni. Per casi in cui serve maggiore precisione su testo moderno, l’opzione --engine spacy-trf seleziona i modelli basati su transformer; l’opzione --engine gliner utilizza GLiNER, un modello locale a cui si indicano le categorie da estrarre (per esempio «insediamento antico», «idronimo», «sito archeologico») senza bisogno di riaddestramento. Entrambe le alternative richiedono l’installazione di pacchetti aggiuntivi ma, come il motore predefinito, funzionano senza connessione e senza servizi esterni.
Per il testo in lingue antiche il consiglio è diverso: piuttosto che affidarsi al riconoscimento automatico, che su latino e greco tende a sbagliare persino la lingua, conviene usare la modalità solo gazetteer descritta più avanti.
Il gazetteer: dalle liste di nomi ai dati geografici
Un gazetteer è, nella forma più semplice, un elenco di nomi di luogo, uno per riga:
PompeiErcolanoStabiaOplontisFornendolo con --gazetteer lista.txt, i nomi presenti nel testo vengono riconosciuti e uniti ai risultati del riconoscimento automatico. Il confronto rispetta i confini di parola — «Como» non viene riconosciuto dentro «Comodo» — ed è insensibile a maiuscole e segni diacritici.
Il gazetteer può però anche essere un file .csv o .tsv con colonne aggiuntive per identificativo e coordinate:
name id lat lonButrint pleiades:530798 39.7456 20.0206Epiro pleiades:991380 39.5000 20.5000In questo caso le coordinate vengono associate ai toponimi riconosciuti e, con -f geojson, esportate come geometrie puntuali. Questo rende immediato l’uso di estratti locali di gazetteer storici come Pleiades per il mondo antico o GeoNames per la geografia moderna: il PDF entra come testo, esce come strato cartografico.
Infine, la modalità --no-ner --gazetteer lista.txt disattiva del tutto il riconoscimento automatico e si limita al confronto con la lista. È deterministica, non richiede modelli linguistici né rilevamento della lingua, ed è la strada da preferire per corpora in latino, greco antico o altre lingue non coperte dai modelli.
Formati di output
L’output predefinito resta l’elenco testuale, comodo per una lettura rapida. Gli altri tre formati servono a integrare i risultati in un flusso di lavoro:
- CSV — una riga per toponimo, con nome, etichetta, occorrenze, pagine, provenienza e, se disponibili, coordinate. Adatto a fogli di calcolo e importazioni in database.
- JSON — l’intero risultato, inclusi metadati sull’esecuzione (lingua, modello, pagine elaborate).
- GeoJSON — una collezione di feature puntuali per i soli toponimi dotati di coordinate, apribile direttamente in QGIS.
La provenienza di ciascun toponimo (ner:GPE, ner:LOC, gazetteer) permette, per esempio, di distinguere i luoghi individuati dal modello da quelli confermati dalla propria lista di controllo.
Interfaccia grafica
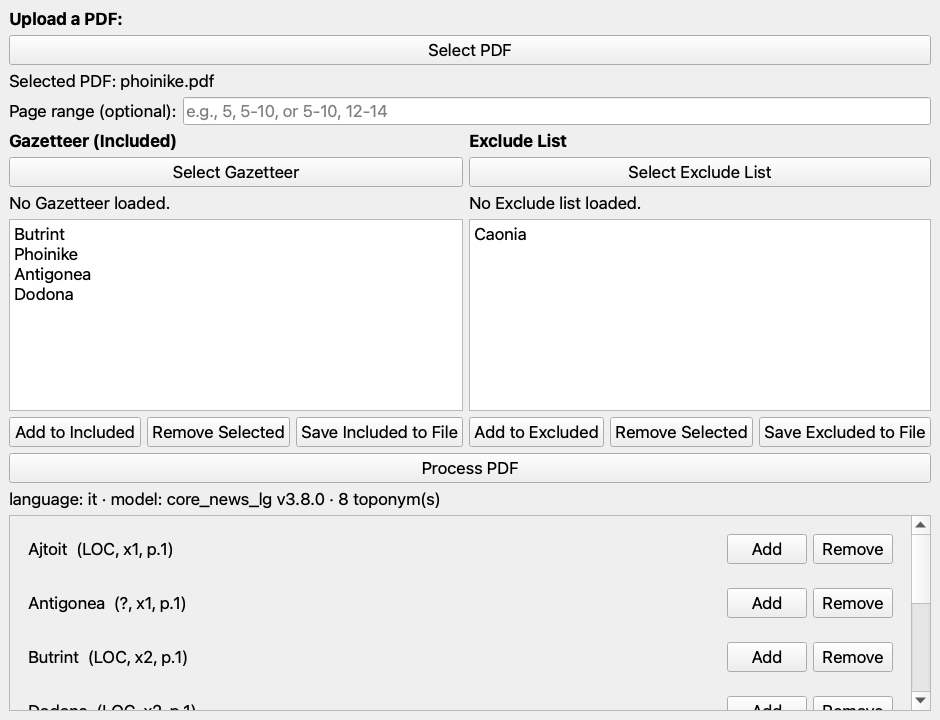
Per chi preferisce non usare il terminale, gui.py offre un’interfaccia costruita con PyQt5 che espone le stesse funzioni: selezione del PDF (anche per trascinamento), intervallo di pagine, gestione interattiva della lista di inclusione (il gazetteer) e di quella di esclusione, e visualizzazione dei risultati con pulsanti per spostare rapidamente un toponimo nell’una o nell’altra lista. Nella versione rivista l’elaborazione avviene in un thread separato: la finestra resta reattiva anche su documenti di centinaia di pagine.
Assistente per Zotero
Molti gruppi di ricerca organizzano già la bibliografia in Zotero con tag tematici. zotero_assistant.py parte da questa pratica, ma richiede una convenzione precisa: i tag che indicano un luogo devono avere il prefisso @ (@Butrint, @Çuka e Ajtoit). Lo strumento legge tutti i tag @ della libreria come vocabolario di riferimento, verifica per ogni articolo quali di quei luoghi compaiono nel PDF allegato e scrive gli eventuali luoghi nuovi con lo stesso prefisso. Senza questa convenzione l’assistente non ha un vocabolario da riusare, e va quindi adottata — per esempio rinominando in blocco i tag di luogo in Zotero — prima di usarlo.
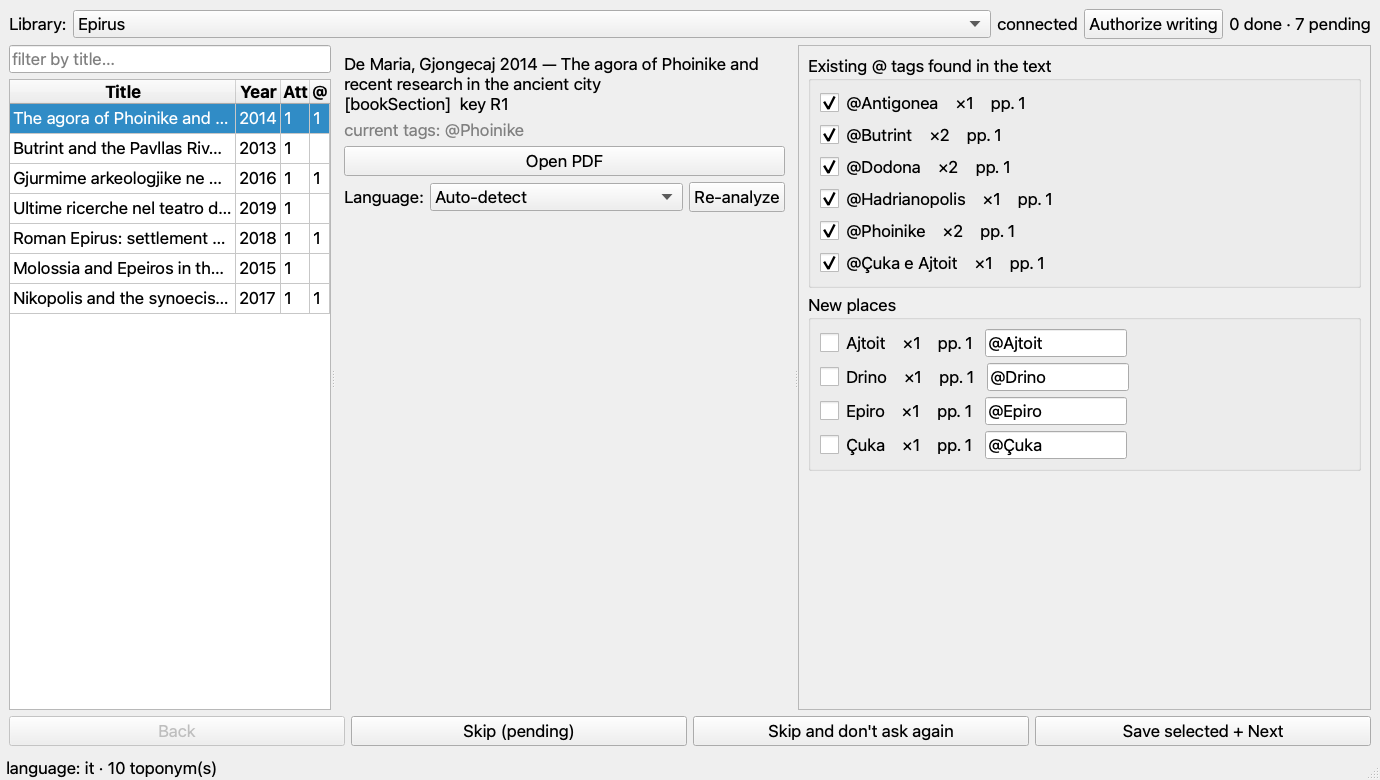
Lo strumento lavora offline, attraverso l’API locale di Zotero (versione 10 o successiva). Scelta una libreria — personale o di gruppo — compaiono i record non ancora contrassegnati come completati. Selezionandone uno, l’assistente ne legge il PDF ed espone due elenchi: i tag @ esistenti trovati nel testo, già spuntati, con numero di occorrenze e pagine; e i nuovi luoghi individuati dal riconoscimento automatico, ciascuno con un campo modificabile per normalizzare la forma e, quando somiglia a un tag esistente, un pulsante per adottarlo. L’utente approva ciò che ritiene corretto; lo strumento riordina alfabeticamente i tag dell’item, li scrive e lo marca come fatto, così da non riproporlo nelle sessioni successive. Ogni azione viene registrata in un file di log.
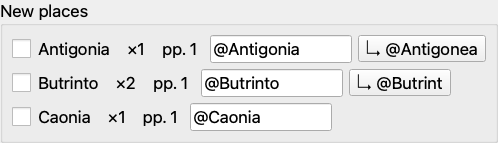
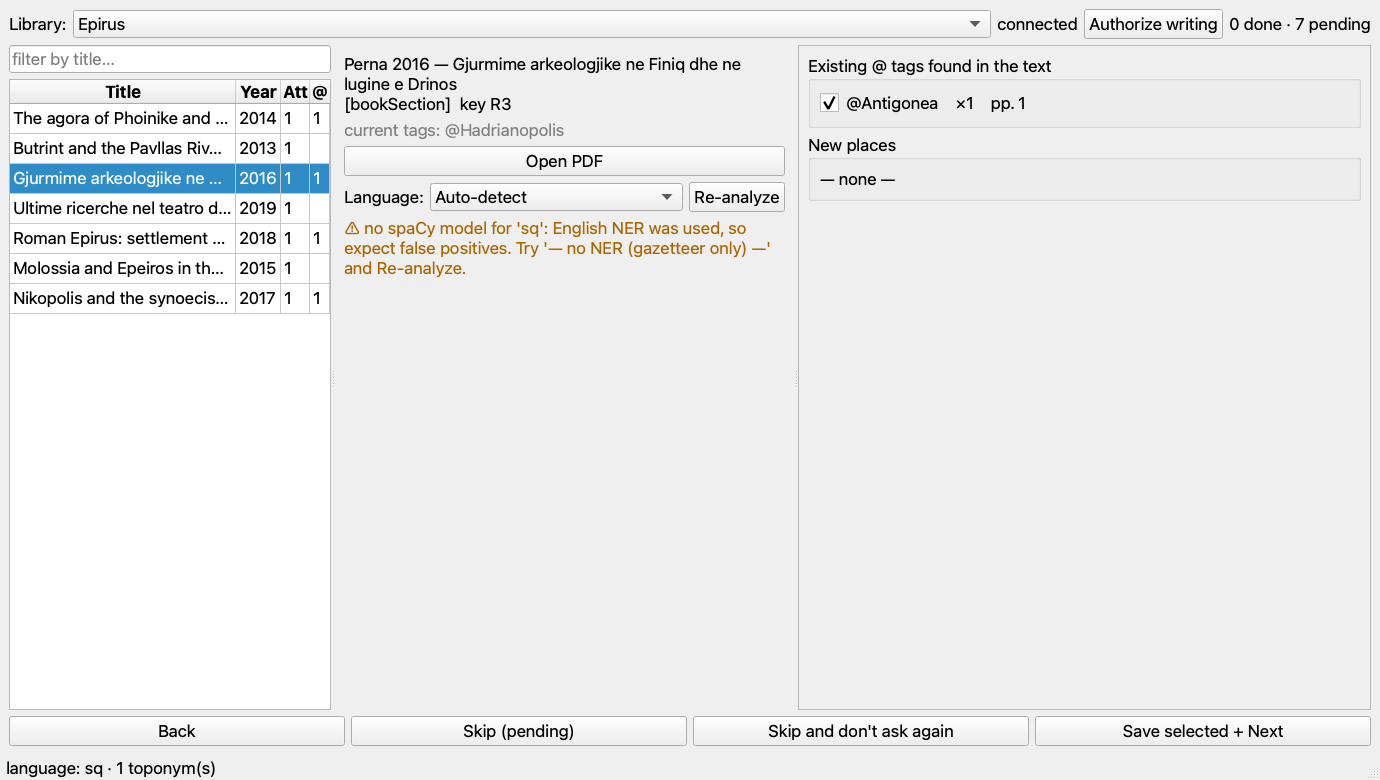
Per gli articoli in lingue prive di un modello di riconoscimento — l’albanese è il caso tipico nella documentazione archeologica dei Balcani — un selettore permette di forzare la lingua oppure di passare a una modalità solo gazetteer, che confronta il testo unicamente con i tag esistenti ed elimina i falsi positivi del riconoscimento automatico.
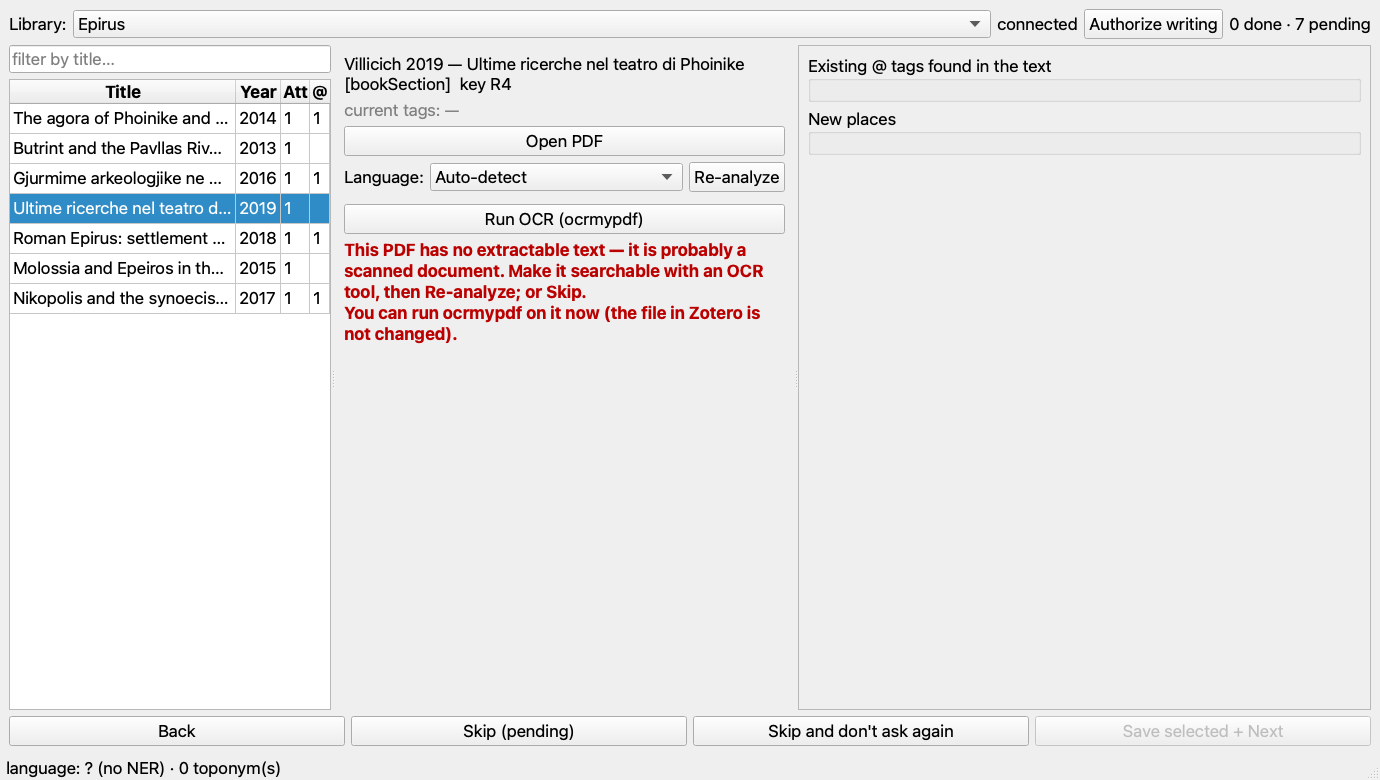
Per i PDF privi di strato testuale (estratti scansionati), se ocrmypdf è installato l’assistente può eseguire l’OCR al volo e rianalizzare; il file così ottenuto può essere salvato su disco, mentre l’allegato in Zotero resta invariato.
Casi d’uso nella ricerca
L’applicazione più diretta è l’organizzazione geografica della bibliografia. Elaborando in blocco una raccolta di PDF e importando i CSV risultanti in un database, si ottiene una tabella che associa ogni pubblicazione ai luoghi che vi compaiono; l’assistente per Zotero descritto sopra fa la stessa cosa direttamente dentro il gestore bibliografico. Da qui si possono interrogare i dati in modo geografico: quali contributi trattano una certa area, quali menzionano insieme due luoghi distanti, come si distribuisce sulla carta la propria biblioteca digitale. Con l’output GeoJSON lo stesso materiale diventa una mappa della copertura bibliografica, utile a individuare regioni poco studiate.
Su corpora più ampi, l’estrazione sistematica dei toponimi consente analisi della distribuzione geografica della ricerca: quali aree ricevono più attenzione, come cambia nel tempo l’interesse per un territorio, quali associazioni di luoghi ricorrono nella letteratura di un ambito disciplinare. Per chi conduce review sistematiche, una passata preliminare su abstract e testi completi fornisce rapidamente il quadro della copertura geografica degli studi esaminati.
Un flusso di lavoro plausibile, a partire da una raccolta di 500 PDF di archeologia classica:
for pdf in biblioteca/*.pdf; do python geoNamesFromPdf.py "$pdf" -f csv -o "toponimi/$(basename "$pdf" .pdf).csv"doneI CSV così prodotti si importano in SQLite o PostgreSQL e si interrogano con SQL ordinario; le colonne con le coordinate, se si è usato un gazetteer georiferito, permettono di passare direttamente alla visualizzazione cartografica.
Installazione e uso
Il progetto richiede Python 3.11 o successivo.
git clone https://github.com/lad-sapienza/geoNamesFromPdf.gitcd geoNamesFromPdf
python3.12 -m venv venvsource venv/bin/activate # su macOS/Linux
python geoNamesFromPdf.py documento.pdfAl primo avvio lo strumento verifica le dipendenze e i modelli linguistici essenziali (italiano e inglese) e propone di installarli automaticamente. Le esecuzioni successive non ripetono il controllo.
Comandi principali:
python geoNamesFromPdf.py articolo.pdf # rilevamento automatico della linguapython geoNamesFromPdf.py -l it documento.pdf # lingua forzatapython geoNamesFromPdf.py documento.pdf -p "10-50" # solo alcune paginepython geoNamesFromPdf.py documento.pdf -f geojson -o out.geojson --gazetteer pleiades.tsvpython geoNamesFromPdf.py --no-ner --gazetteer antichi.txt documento.pdfpython geoNamesFromPdf.py --list-languages # modelli installatipython geoNamesFromPdf.py --install-language es # aggiunge lo spagnolo
python gui.py # interfaccia grafica (un PDF)python zotero_assistant.py # assistente per ZoteroLingue supportate
Lo strumento è preconfigurato per dieci lingue — italiano, inglese, spagnolo, francese, tedesco, portoghese, olandese, greco moderno, polacco e rumeno — installabili singolarmente con --install-language. L’elenco è definito nel modulo core.py e si estende facilmente ad altre lingue per cui esista un modello spaCy con riconoscimento delle entità. La copertura multilingue è particolarmente utile in contesti di ricerca internazionali, dove la bibliografia è spesso in più lingue.
Affidabilità e sviluppo assistito da IA
La revisione ha aggiunto una suite di test automatici (pytest, oltre cinquanta) che verifica offline, senza scaricare modelli né richiedere un’istanza di Zotero, il comportamento delle funzioni pure: analisi degli intervalli di pagina, confronto con il gazetteer, lettura dei file in vari formati, serializzazione, e il dialogo con l’API locale di Zotero simulato. È un test di questo tipo che avrebbe intercettato, a suo tempo, l’errore nell’espressione regolare del gazetteer.
Vale la pena essere espliciti sul metodo di lavoro. La prima versione di geoNamesFromPdf, nell’ottobre 2025, era stata scritta interamente con l’assistenza di Claude Sonnet 4.5 tramite GitHub Copilot. La revisione dell’agosto 2026 è stata condotta con Claude Sonnet 5 tramite Claude Code, in una sessione che è partita da una revisione critica del codice esistente — è così che sono emersi il bug del gazetteer e gli altri problemi — ed è proseguita con la riprogettazione dell’architettura, l’aggiunta delle nuove funzionalità e la stesura dei test e della documentazione. È un esempio concreto di come questi strumenti possano abbassare la soglia tecnica per chi, nella ricerca umanistica, ha bisogno di software su misura: non solo per scrivere codice nuovo, ma per rivedere e consolidare quello esistente.
Conclusioni
geoNamesFromPdf resta uno strumento volutamente circoscritto: fa una cosa — trovare i luoghi in un PDF — e cerca di farla bene, restando semplice da installare e da usare. La revisione del 2026 lo rende però adatto anche al lavoro su scala maggiore: elaborazione di interi volumi, output che si integra con GIS e database, gazetteer che portano coordinate, una modalità pensata per le lingue antiche e un assistente che porta tutto questo dentro Zotero. Tutto senza rinunciare al funzionamento offline e senza dipendere da servizi esterni.
Link e risorse
- Repository: github.com/lad-sapienza/geoNamesFromPdf
- Licenza: MIT
- Tecnologie: Python, spaCy, PyMuPDF, langdetect; opzionali spacy-transformers e GLiNER
- Segnalazioni e contributi: Issues su GitHub